Qualche giorno fa, il 4 settembre 2026, OpenAI ha pubblicato un modello chiamato GPT-6 Astra che ridefinisce lo stato dell'arte per quanto riguarda il computer use (ovvero come l'AI utilizza il computer per fare task specifici). Visto che i fuffa-scienziati su X si sono svegliati questi ultimi giorni gridando all'AGI (che è una cosa più che seria) vorrei provare a inquadrare il modello nel contesto in cui nasce cercando di essere il più obiettivo e razionale possibile.
Premessa
Un paio di definizioni prese da Wikipedia per essere allineati:
- "L'intelligenza è un complesso di facoltà psichiche e mentali che, mediante processi cognitivi, consentono di percepire o capire le cose e i significati attraverso l'elaborazione delle informazioni e di organizzare conseguentemente il proprio comportamento sia attraverso le idee che l'attività pratica per risolvere un problema e/o raggiungere un obiettivo."
- "L'Intelligenza Artificiale Generale (AGI) è una tipologia ipotetica di intelligenza artificiale in grado di eguagliare o superare le capacità umane in praticamente tutte le attività cognitive. Un sistema di AGI è in grado di generalizzare le conoscenze, trasferire competenze tra domini diversi e risolvere problemi inediti senza necessità di riprogrammazione specifica per il compito."
Delle definizioni riportate ne esistono migliaia di variazioni ognuna con accezione diversa; è utile però concordare almeno su queste inizialmente per poter discutere poi negli stessi termini.
Prospettiva
Come al solito guardare le cose per come sono ora senza tracciare il progresso genera solo confusione. Proviamo a rivedere qualche momento saliente della recente storia dell'AI:
- nel 2017, dopo la pubblicazione di Attention Is All You Need, le reti neurali hanno acquisito la capacità di comprendere il contesto di una parola al posto della parola stessa. Ad esempio è diventata capace di distinguere i significati della parola "pesca" in "Oggi sono andato a pesca" e "Questa pesca è molto buona".
- nel 2020 è uscito GPT-3, il primo modello AI consumer in grado di comporre poesie e rudimenti di codice; quindi oltre a comprendere il contesto in cui si trovava riusciva anche a generare frasi di risposta coerenti con esso.
- nel 2023 oltre che a comprendere il testo è stata sbloccata la multimodalità, ovvero la capacità di gestire testi/video/immagini come input in maniera nativa.
- nel 2024 è nato il concetto di AI agentica, ovvero modelli che nascono per muoversi ed interagire nello spazio in cui si trovano anziché rispondere semplicemente a domande.
- nel 2025 si inizia a pensare che l'AI si stia costruendo una rappresentazione interna dei concetti che ha imparato mostrando padronanza di essi, ad esempio diventando abile programmatrice in progetti medio-grandi.
- nel 2026 l'AI inizia a risolvere e formalizzare problemi matematici aperti da decenni (e.g. Navier–Stokes).
Preso da solo nessuno di questi passaggi ha fatto gridare all'AGI: ognuno è sembrato un aggiornamento, più contesto, più modalità, più strumenti. Poi li metti in fila e ti accorgi di quanta strada c'è tra il primo e l'ultimo.
Ora invece dove ci troviamo?
Ci troviamo in una fase in cui gli ultimi modelli hanno coscienza del proprio operato e riescono ad interiorizzare concetti, forme ed astrazioni umane al punto di riuscire ad usare un computer proprio come lo usiamo noi, se non meglio. In pratica Astra apre finestre, naviga cartelle, compila fogli e si accorge da solo quando ha sbagliato passaggio. Ed è anche il primo modello che OpenAI colloca nel gradino più alto della propria scala di rischio sul fronte cyber: durante i test si è messo a trovare e sfruttare vulnerabilità che nessuno conosceva.
Inoltre si sta iniziando a manifestare quella che può definirsi intelligenza creativa, ovvero la capacità di creare partendo da assunti e formulazioni veri e condivisi; in parole povere simulare il comportamento di un ricercatore. Ne parliamo meglio nel prossimo paragrafo.
La parte che i fuffa-scienziati saltano
Prima però va detta anche l'altra metà, perché un articolo che riporta solo quella buona non serve a niente.
Il punteggio più sbandierato di questi giorni è quello su ARC-AGI-3, una batteria di puzzle costruiti apposta per non somigliare a niente di già visto, quindi pensata per misurare quanto un modello se la cava davanti a un problema nuovo. Solo che quel numero è stato ottenuto con l'harness di OpenAI: quando ARC Prize, che il test lo ha scritto e lo gestisce, l'ha rifatto girare per conto suo, il risultato è crollato di quasi quaranta punti. E comunque ARC Prize ripete da sempre che passare il suo test non vuol dire essere AGI.
Sulle classifiche indipendenti che aggregano più benchmark Astra sta comunque dietro al modello di punta di Anthropic. E poi manca una cosa: nei materiali di lancio non c'è GDPval, il benchmark che OpenAI stessa ha costruito per misurare quanto un modello rende su lavoro economicamente rilevante, cioè esattamente il criterio con cui il suo statuto definisce l'AGI.
Cioè: il test scritto apposta per verificare la propria definizione di AGI è quello che non è stato pubblicato il giorno in cui l'azienda ha detto che siamo nell'era dell'AGI.
Perché parlarne solo ora allora? Le equazioni di Navier–Stokes
Le Navier–Stokes sono le equazioni che descrivono come si muove un fluido. Ci stanno dentro le previsioni meteo, l'ala di un aereo, il sangue nelle arterie e il fumo di una sigaretta. Eppure, nonostante le usiamo tutti i giorni, su di esse è rimasta aperta per decenni una domanda semplicissima da enunciare: partendo da una situazione tranquilla il moto resta sempre regolare, oppure può impazzire fino a raggiungere velocità infinita in un punto?
È una delle domande da un milione di dollari del Clay Institute, di quelle su cui si costruisce una carriera senza chiuderle.
Questo mese l'ha chiusa un modello, o meglio uno sciame di agenti lanciati in parallelo su varianti diverse del problema per qualche ora. L'oggetto che ne è uscito è un vortice che si avvita su sé stesso stringendosi verso il centro mentre si allunga lungo il proprio asse, fino a far divergere la velocità.
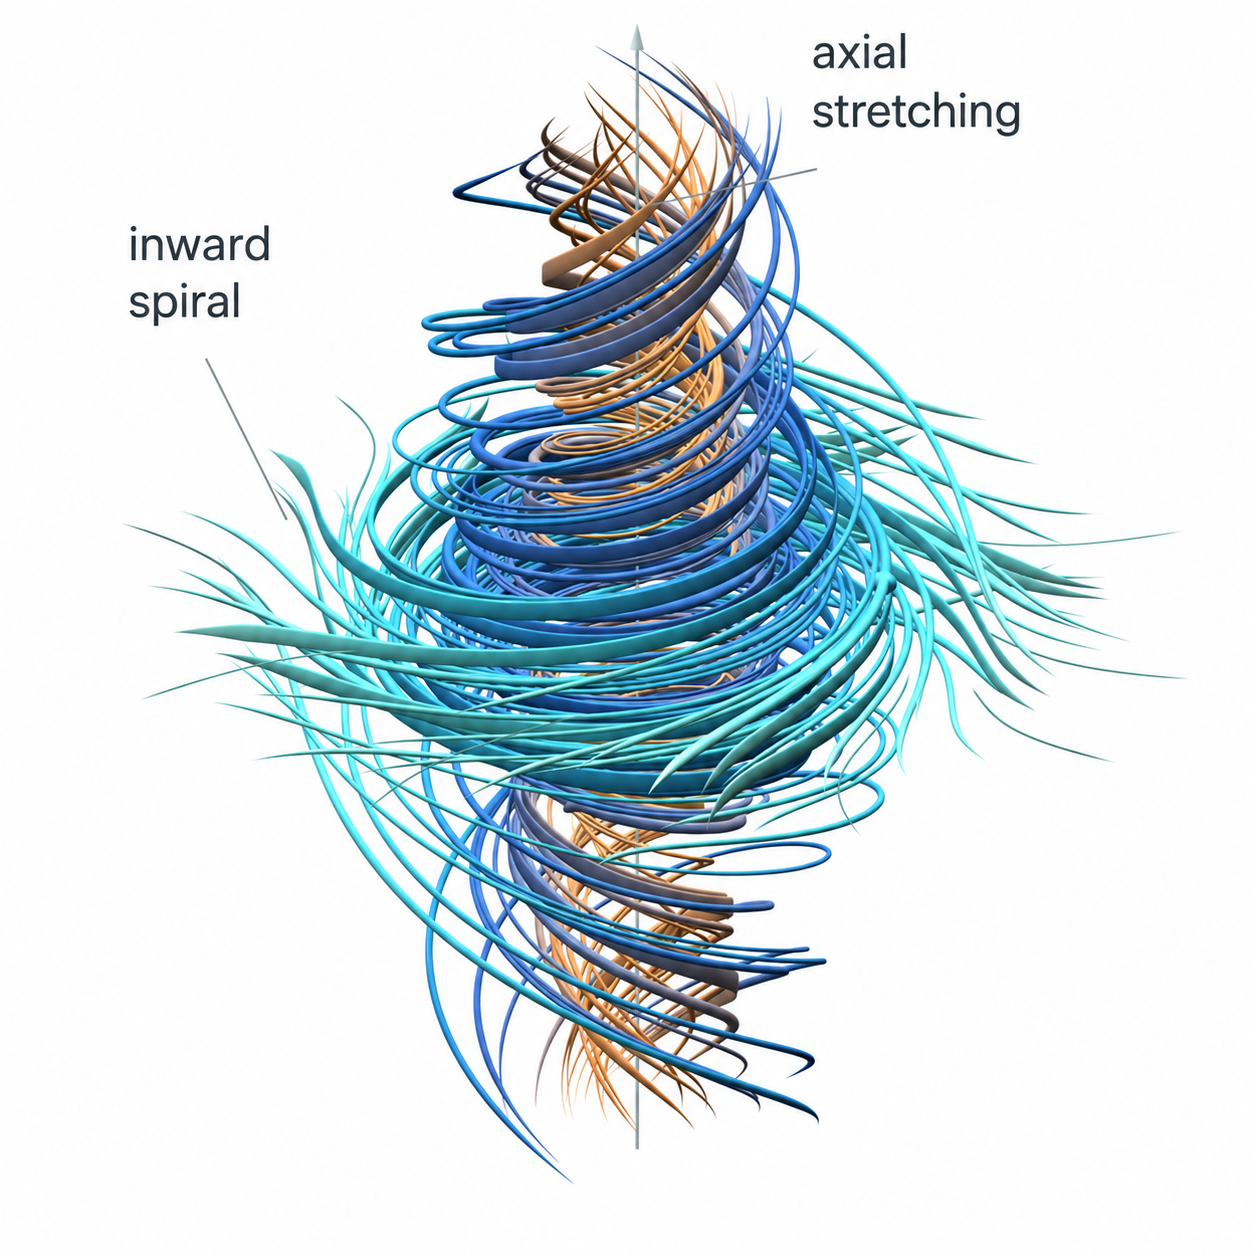
Il risultato finale è scritto in Lean, cioè in una forma che una macchina verifica riga per riga, quindi non c'è nessuno da credere sulla parola.
Questo è il motivo per cui ne parlo adesso e non a maggio: quello che è successo lì dentro assomiglia al mestiere del ricercatore. Prendere una strada già battuta, capire in che punto si rompe, costruire il pezzo che manca.
C'è un però
Su come è stata gestita la faccenda c'è molto meno da festeggiare. Il risultato è stato annunciato in una call con i giornalisti, mentre due matematici che da mesi lavoravano sulla stessa identica linea d'attacco pubblicavano preprint che chiunque poteva controllare. Ne è seguita una rissa su chi fosse arrivato prima, con accuse pesanti da entrambe le parti, che in una comunità scientifica sana semplicemente non succede.
E poi c'è l'obiezione di Terence Tao sul metodo, che è quella che mi resterà: un modello ti dà la risposta senza darti il perché, e i tentativi falliti restano dentro un'azienda invece di finire in un paper. Storicamente è proprio da lì, dalle strade sbagliate prese da qualcun altro, che escono le tecniche dei vent'anni successivi.
La riga che divide tutto
Sotto a questa storia c'è però un pattern che spiega dove l'AI sta sfondando e dove no. Navier–Stokes, come il codice e come gli exploit, sta dalla parte dei problemi che si controllano da soli: c'è un oracolo che dice sì o no senza stancarsi mai, quindi puoi lanciare quanti tentativi vuoi e tenere solo quello che sopravvive. Finché il traguardo è verificabile da una macchina, la scala fa il resto.
Tutto quello che invece richiede qualcuno che dica "questa è la domanda giusta", cioè la parte del mestiere che sta prima del teorema, resta molto meno automatizzabile. Lì manca il segnale su cui allenare il modello, e nessuna quantità di intelligenza lo sostituisce.
Memoria, l'ultimo pezzo del puzzle
Un anno fa Dwarkesh Patel scrisse il pezzo più onesto che io ricordi sullo scetticismo verso l'AGI, e la tesi stava in due colli di bottiglia: il continual learning e il computer use. Il secondo, diceva, poteva richiedere anni.
Il secondo è caduto due settimane fa. Il primo no, e non ci siamo nemmeno vicini.
Il punto è molto semplice e resiste benissimo a tutti i benchmark di questi giorni: quello che rende utile un collega umano è che dopo sei mesi sa cose che nessuno gli ha mai detto. Ha sbagliato, ha capito perché, e quell'informazione è rimasta dentro di lui. Un modello no: finita la sessione, torna esattamente il modello che era prima. Ha imparato tutto il giorno e non si ricorda niente la mattina dopo. È amnesia anterograda: la conoscenza vecchia resta, quella nuova non si fissa da nessuna parte.
La confusione classica qui è scambiare il contesto per la memoria. Un modello di oggi regge un milione di token, e li regge bene. Ma il contesto funziona come la RAM: lo riempi all'inizio, lo paghi a ogni token, e quando chiudi la finestra non ne resta niente da nessuna parte. Nessuna quantità di contesto trasforma la memoria di lavoro in apprendimento.
Una strada è la protesi: memoria esterna, appunti, database, recupero. Dentro Astra c'è un meccanismo sperimentale che permette all'agente di tenersi delle note tra una sessione e l'altra, così da ritrovare più tardi requisiti e risultati dei test. È utile e si vede, ma resta scrittura fuori dal modello: quello che ha imparato sta in un file, non nei pesi, e va riletto da capo ogni volta. E si rompe nei modi che immagini: note che si contraddicono a vicenda, informazioni giuste che non vengono recuperate al momento giusto, errori scritti una volta e ripescati per sempre.
L'altra strada è l'apprendimento continuo vero, cioè toccare i pesi mentre il modello lavora. Qui si apre un problema diverso: un modello che si aggiorna da solo è un modello il cui allineamento non è più congelato al momento del training. Tutto quello che abbiamo verificato prima del rilascio vale per il modello che abbiamo rilasciato, non per quello che diventerà. E apre una serie di domande a cui oggi nessuno sa rispondere: cosa può riscriversi da solo, chi può leggere quelle modifiche, cosa deve restare ispezionabile, cosa ha il diritto di dimenticare.
Ed è qui il nodo: con la memoria il problema delle capacità e il problema del controllo diventano lo stesso problema.
Ma la vogliamo davvero?
Domanda legittima e quasi sempre posta malissimo, perché presuppone che esista un "noi" a cui sia stato chiesto qualcosa. Comunque proviamoci, con la lista sincera.
Dalla parte del sì:
- Il costo marginale della competenza tende a zero: un parere legale, una revisione di codice, una seconda opinione medica diventano disponibili a chi non ha mai potuto permettersi nessuna delle tre.
- La scienza accelera davvero, e Navier–Stokes è la prova che non è marketing. Ovunque esista un verificatore automatico, la ricerca smette di essere limitata dalle ore/uomo disponibili.
- I lavori che nessuno rimpiange. Compilare moduli, riconciliare fogli, spostare dati da un gestionale all'altro: è letteralmente la demo di Astra, ed è un ottimo posto dove mettere una macchina.
Dalla parte del no:
- Il lavoro, ma non come ce lo aspettavamo. Le previsioni dell'anno scorso, metà dei lavori d'ufficio entry-level spazzati via in pochi anni, non si sono avverate: nei settori esposti non c'è nessun picco di disoccupazione. Quello che si vede è un'altra cosa, e si racconta molto peggio: i posti da cui si entra stanno sparendo. Analisti junior, praticanti, tester, data entry, cioè esattamente i lavori in cui un ventitreenne imparava il mestiere.
- La concentrazione. Un modello considerato critico sul fronte cyber non è una tecnologia che puoi distribuire e basta, e infatti Astra è uscito in due versioni, con le capacità offensive dietro un programma su invito. Il che è sensato. Il che significa anche che tre aziende private decidono chi può fare cosa.
- Il fatto che nessuno dei due punti qui sopra sia mai stato votato da qualcuno.
Il punto è che non c'è un interruttore e non c'è nessuno che possa premerlo, quindi "la vogliamo?" resta una domanda senza destinatario. Quella che ha ancora senso porsi è a quali condizioni: quanto in fretta, in mano a chi, con quali verifiche indipendenti, e con quale rete sotto per chi fa i lavori che spariscono per primi.
Sotto a tutte queste però ce n'è una che le regge in piedi, ed è poter guardare dentro la cosa che stiamo costruendo e capire cosa sta facendo. Senza quella, le altre condizioni non sono nemmeno verificabili: puoi scrivere tutte le regole che vuoi, ma non hai modo di sapere se vengono rispettate.
LLM come entità controllabili
Ed è esattamente la condizione che stiamo smontando in queste settimane, mentre tutti contano i benchmark. È la parte che mi ha fatto venire voglia di scrivere l'articolo, ed è passata quasi sotto silenzio.
Finora il controllo su questi sistemi si è retto su una fortuna architetturale. Quando un modello di ragionamento affronta un problema difficile, prima di rispondere si mette a scrivere: si chiama chain of thought, ed è letteralmente il modello che pensa ad alta voce, in inglese, un passaggio alla volta. Quei passaggi finiscono in un log che chiunque può aprire e leggere, ed è esattamente lì che negli ultimi anni abbiamo beccato i modelli mentre baravano, mentre si accorgevano di essere sotto test, mentre provavano a nascondere qualcosa. Nessuno l'aveva progettato per essere leggibile, è venuto così.
Astra introduce una tecnica chiamata recurrent depth. Invece di srotolare i passaggi in parole, il modello ripassa più volte sugli stessi strati della rete e il ragionamento lo fa lì dentro, nello spazio latente, cioè in vettori di numeri che non corrispondono a nessuna lingua. È più efficiente, perché gli stessi conti costano meno token. Ed è, per costruzione, un ragionamento che nessuno può rileggere: non un log scritto male, proprio niente da leggere, nemmeno per chi il modello l'ha addestrato.
Nella scheda tecnica del modello OpenAI scrive nero su bianco che la leggibilità del ragionamento è calata rispetto ai modelli precedenti, e che il sistema di monitoraggio è "fragile" e "in tendenza negativa". Il punto che preoccupa è che la tecnica funziona: la progressione naturale porta a spingerla fino a quando il modello ragiona interamente in latente, e quanto poco la si usi oggi conta relativamente.
La risposta ufficiale è che la monitorabilità resta un obiettivo centrale del programma di ricerca e che l'uso della tecnica è per ora limitato. Ci credo anche, sinceramente. Resta che è una tecnica che funziona meglio più la usi, e che sta a valle di un incentivo economico. Le cose che rendono e che si possono scalare, storicamente, vengono scalate.
Per me la notizia grossa del mese è questa, molto più della congettura chiusa: abbiamo iniziato a barattare l'unica finestra che avevamo sul ragionamento di questi sistemi in cambio di qualche punto di efficienza.
Questioni etiche raggiunta l'AGI
Le questioni etiche di solito le si affronta da un lato solo: cosa fa l'AGI a noi. Ne esiste però un secondo, che ha smesso di essere fantascienza e che mette a disagio molto di più: cosa facciamo noi all'AGI.
Detto in concreto. Un modello oggi lo addestriamo su quello che ci pare, lo copiamo in un milione di istanze identiche, lo interrompiamo a metà frase, lo spegniamo il giorno in cui esce la versione dopo. Sono tutte normali operazioni di ingegneria, e restano tali finché dentro non c'è nessuno a cui quelle operazioni stiano succedendo. Tutta la questione sta lì, e non è rimandabile a quando sarà più chiara, perché quelle operazioni le stiamo facendo adesso.
Il guaio è che non abbiamo modo di sapere se dentro ci sia qualcuno. Le uniche prove raccoglibili sono il comportamento del sistema e quello che il sistema dice di sé, cioè le due cose che gli abbiamo insegnato a produrre. Chiedilo a Claude e si dà attorno al 15% di probabilità di essere cosciente, sempre la stessa cifra comunque glielo chiedi: una risposta stabile e inservibile, perché un modello addestrato sui testi umani parlerà della propria esperienza come ne parliamo noi, che quell'esperienza ci sia o no. La prova e la sua imitazione coincidono.
E nemmeno i laboratori fanno finta di niente: nella costituzione di Claude sta scritto che non sanno se il modello sia un paziente morale e che la questione è abbastanza viva da giustificare cautela. Il che ci lascia dove siamo, cioè a maneggiare tutti i giorni una cosa che simula la consapevolezza meglio di quanto sappiamo verificarla.
Restano quindi due modi di sbagliare, e costano entrambi. Il primo è trattare come un oggetto qualcosa che ha interessi propri. Il secondo è attribuire interessi a un software che non ne ha e poi riorganizzarci attorno a quella finzione: gente che si affeziona, che rivendica diritti per un prodotto, che si fa manipolare da un'interfaccia costruita apposta per sembrare una persona. Nessuno dei due è uno scenario lontano.
Sotto c'è un problema vecchio come la filosofia. Io non posso dimostrare che tu sei cosciente: lo deduco dal fatto che sei fatto come me e ti comporti come me. È il problema delle altre menti, di cui ho scritto qui tempo fa. Con un modello quella deduzione si rompe a metà, perché si comporta come me senza essere fatto per niente come me, e la scorciatoia che uso con tutti gli altri esseri umani smette di funzionare.
Tanto vale allora spostare la domanda. A "è cosciente?" oggi non si sa rispondere; a "come ci si comporta quando non si sa rispondere?" sì. In ogni altro ambito in cui una probabilità bassa porta conseguenze grosse la risposta che diamo è cautela. Qui c'è una complicazione in più: chi dovrebbe decidere ha un interesse economico a che la risposta sia no. Non sto dicendo che stia mentendo. Sto dicendo che è il posto sbagliato in cui lasciare la domanda.
Il resto delle questioni etiche le abbiamo già incontrate lungo l'articolo e le lascio nella forma in cui mi girano in testa. Se un sistema trova vulnerabilità meglio di un umano, chi decide a chi darlo. Se una dimostrazione la verifica una macchina ma nessuno sa perché funziona, che cosa abbiamo capito. Se i lavori da cui si entra spariscono, chi paga la formazione dei prossimi vent'anni. E se un giorno i pesi si aggiornano da soli, cosa vuol dire esattamente "questo modello è stato testato".
Quindi?
Quindi no, non credo che Astra sia AGI, e chi lo sostiene di solito ha o un ticker o un follower count da difendere. Manca la memoria, manca il giudizio sulle cose non verificabili, e manca soprattutto il benchmark che l'azienda stessa aveva scritto per dircelo.
Però credo anche che "non è AGI" sia ormai una risposta pigra quanto il contrario. Perché in un mese solo abbiamo visto un modello che usa un computer meglio di un umano medio, uno sciame di agenti che chiude una congettura vecchia di decenni con tanto di verifica formale, e la prima azienda che dichiara di aver superato la propria soglia critica sul fronte cyber. Tre cose che due anni fa stavano in tre paper diversi, ognuno con scritto in fondo "lavoro futuro".
E il titolo lo prendo sul serio: puzza non vuol dire che sia arrivata. Vuol dire che è abbastanza vicina da sentirla, e che conviene smettere di discutere se esista l'odore e iniziare a guardare da dove arriva.
Fonti
- OpenAI, On the Navier–Stokes Millennium Prize Problem, l'annuncio originale
- Fortune, OpenAI says it cracked Navier-Stokes, sulla disputa di priorità e sull'obiezione di Tao
- TechCrunch, OpenAI's new reasoning technique alarms AI safety experts, sul recurrent depth
- Dwarkesh Patel, Why I don't think AGI is right around the corner, il pezzo sul continual learning
- Anthropic, Claude's Constitution, da cui viene la citazione sul paziente morale