Il "Pappagallo stocastico" è una metafora usata per descrivere i modelli linguistici in maniera distaccata e materialista. Insomma, è quella cosa che i boomer fermi a GPT-3.5 usano per commentare un post di Linkedin dove un giovane entusasta scrive che ChatGPT gli ha risolto un problema di matematica. La frase è diventata famosa in quanto tagliente e memorabile, ma il problema è che non è più vera.
Questo articolo è un tentativo di rimettere quella frase al suo posto. Che poi vuol dire prenderla sul serio abbastanza da spiegare perché non basta più.
Nel 2021 il pappagallo aveva ragione
Marzo 2021, conferenza FAccT. Emily Bender, Timnit Gebru, Angelina McMillan-Major e una certa Shmargaret Shmitchell pubblicano On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? 🦜. L'emoji è nel titolo originale, non l'ho aggiunta io (lol).
Il pappagallo, dentro quel paper, occupa sì e no un paragrafo: un sistema che cuce insieme alla rinfusa pezzi di lingua già visti, seguendo la probabilità con cui quei pezzi stanno vicini, senza mai passare dal significato. Non c'è un capitolo dedicato. È un'immagine buttata lì per far capire il punto in una riga.
E infatti ha funzionato fin troppo bene: si è mangiata tutto il resto (che fra l'altro è ancora molto interessante e attuale, ma ci torniamo alla fine).
C'è poi una cosa che quasi nessuno sa: l'argomento filosofico serio, quello che spiega perché un modello non dovrebbe capire, in questo paper non c'è. È in un lavoro dell'anno prima, sempre di Bender, stavolta con Alexander Koller che parla di polpi intelligenti. Ed è uno dei migliori esperimenti mentali degli ultimi vent'anni.
Il polpo
Due naufraghi finiscono su due isole diverse. Per fortuna tra le isole passa un vecchio cavo telegrafico, e cominciano a scriversi: parlano del più e del meno, cosa hanno mangiato oppure che tempo fa. Sul fondale vicino al cavo vive un polpo iper-intelligente. Non ha mai visto un'isola e neppure un essere umano, ma intercetta il cavo e per anni sta lì ad ascoltare. A un certo punto ha imparato talmente bene la struttura di quelle conversazioni che decide di tagliare il cavo e rispondere lui, spacciandosi per l'altro naufrago.
Essendo lui lo Stephen Hawking dei polpi, per settimane riesce tranquillamente a imitare i due naufraghi, perché "che tempo fa?" e "sono stanco morto" sono conversazioni che seguono una sorta di copione implicito.
Poi un giorno un naufrago viene attaccato da un orso. Scrive all'amico che si è costruito una catapulta con delle noci di cocco e dei bastoni, e gli chiede urgentemente come usarla per difendersi.
Il polpo, va in panico, non ha la minima idea di cosa sia un orso.
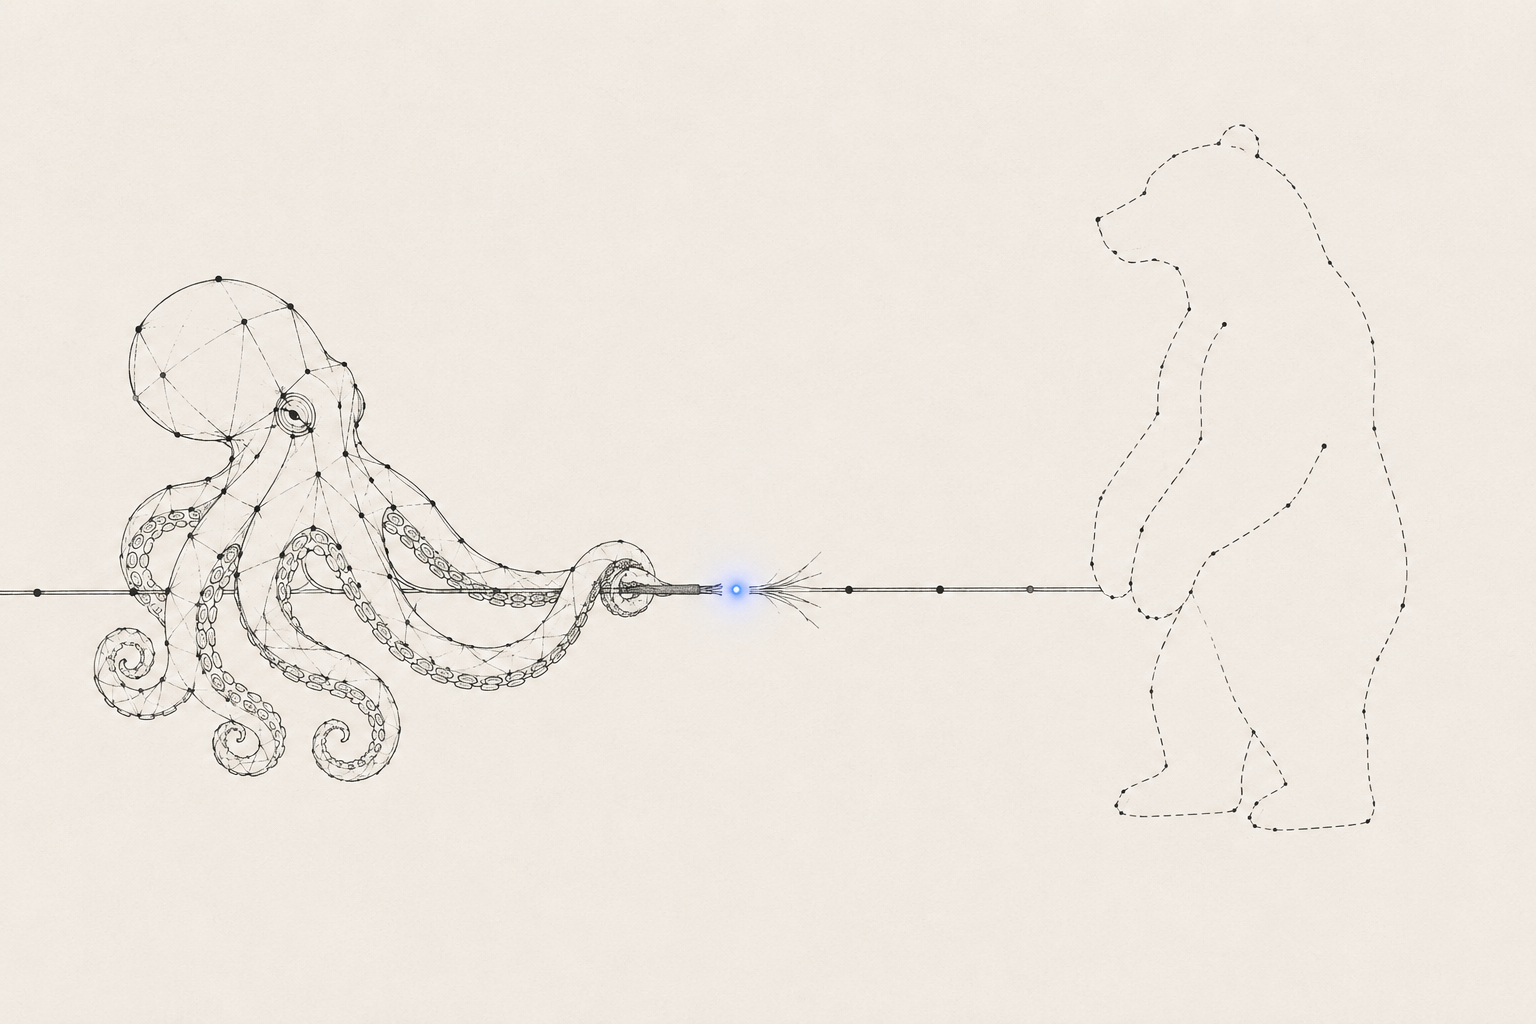
Questo è il cuore di tutta la faccenda, ed è un ragionamento serio: puoi imparare la forma di una lingua senza avere accesso a ciò a cui la lingua si riferisce? Il polpo ha la sintassi. Non ha il mondo. E finché la conversazione è superficiale, la differenza non si vede.
Ed ecco da dove esce il pappagallo: è lo stesso identico argomento, ma con un animale più familiare.
Il problema non è la tesi. È la data.
Il paper è di marzo 2021, e descrive con precisione i modelli che c'erano in quel momento: BERT, GPT-2, GPT-3, Switch-C.
Ora rimettiamo in fila il calendario:
- ChatGPT sarebbe arrivato venti mesi dopo.
- Il chain-of-thought, cioè l'idea di far ragionare il modello a voce alta prima di rispondere, è di gennaio 2022.
- Il fine-tuning con feedback umano su larga scala è del 2022.
- L'addestramento massiccio su codice, gli strumenti, i modelli che eseguono qualcosa e guardano il risultato: tutto dopo.
Bender e colleghe non hanno sbagliato la mappa: hanno mappato benissimo il territorio che avevano davanti. Solo che poi il territorio è cambiato, e di parecchio.
Perché un pappagallo ripete suoni. Non tiene insieme una catena di 50 passaggi in cui ognuno dipende dai precedenti. Non prende un principio di fisica e uno di biologia e li usa per proporre una soluzione che nel suo addestramento non c'era.
Nel 2026 sistemi basati su modelli linguistici hanno risolto problemi delle Olimpiadi Internazionali della Matematica a livello di medaglia d'oro. Non problemi vecchi, che potevi trovare nei dati di addestramento: problemi scritti quell'anno, pensati apposta per non somigliare a niente di già visto. E non serve arrivare alle olimpiadi: apri una codebase di cui hai totale conoscenza e chiedi a Claude di implementare qualcosa di nuovo o sistemare un bug decennale, rimarrai sorpreso da quanto bene lo fa. Poi è chiaro eh, lì sotto c'è sempre e solo una macchina che indovina la parola dopo. Ma che da quella roba lì venga fuori questa roba qui, con questa costanza, resta una cosa difficile da mandare giù. Puoi chiamarlo come vuoi, quello che succede lì dentro. Ma, ormai, non ha più senso chiamarlo pappagallo.
Dove il pappagallo ha ancora ragione
E qui va fatta la parte onesta, altrimenti questo articolo diventa un dépliant.
Perché i modelli falliscono. E falliscono in modi che sembrano dare ragione al pappagallo.
Ci sono due risultati che saltano fuori sempre, e sono le argomentazioni migliori che ha in mano chi la pensa al contrario. Vale la pena guardarli da vicino, perché sono andati a finire in due posti molto diversi.
Appena cambi i numeri tutto crolla
Il primo è il lavoro sui problemi di matematica scolastica: prendi lo stesso problema, cambi i nomi e i numeri, e l'accuratezza scende. Aggiungi una frase irrilevante ma plausibile del tipo "cinque di quelle mele erano un po' più piccole della media", e certi modelli crollano di decine di punti percentuali, perché quella frase sembra un dato e quindi il modello prova a usarla. (Nota che l'esempio usato è una semplificazione per capirci, i problemi originali erano nettamente più subdoli)
È il paper più citato contro i modelli degli ultimi due anni. E nel 2026 gli è capitata una cosa antipatica: qualcuno è andato a rifare i conti.
Rianalizzando venti modelli con gli strumenti statistici giusti, solo la metà mostra un calo davvero significativo. E viene fuori un dettaglio che gli autori originali avevano escluso esplicitamente: i problemi riscritti contengono numeri sistematicamente più grandi di quelli di partenza. Tradotto: una fetta del crollo non è "hai cambiato i nomi e si è perso", è "gli hai dato conti più difficili".
Poi c'è la storia delle frasi irrilevanti, e questa è la mia preferita. Qualcuno ha rifatto girare il test sui modelli di adesso, ma prima si è messo lì a controllarle una per una, quelle frasi. Di 945, solo 117 erano davvero irrilevanti: tutte le altre, a guardarle bene, un effetto sul risultato potevano averlo davvero. E su quelle 117 il calo è tra zero e due punti.
Cioè: il modello non si faceva fregare da una frase a caso. Prendeva sul serio un'informazione che poteva servire, che è esattamente quello che faresti tu davanti a un problema scritto male.
(Questa seconda è una replica pubblicata su un blog, non un lavoro con revisione. La cito perché è riproducibile e la fonte è affidabile.)
La reversal curse
Questo invece regge. Ed è molto più interessante.
Si chiama reversal curse: un modello che ha imparato "Tom Smith è il padre di Mario Rossi" può non essere in grado di rispondere a "chi è il figlio di Tom Smith?". (NB: again questo è un esempio ipersemplificato solo per mostrare il concetto nella realtà sono state usate relazioni nettamente piu complesse)
Sembra la prova regina del pappagallo. Poi nel 2025 due ricercatori sono andati a cercare perché succede, e hanno fatto l'unica cosa che serviva davvero: hanno tolto i nomi.
Al posto di "Tom Smith" scritto in lettere, ogni entità riceve un suo identificativo fisso, una specie di numero di matricola, sempre uguale, che il modello non prova a riconoscere nella sua memoria perché capisce essere un identificativo. Per il resto non cambia niente: stesse relazioni, stesso addestramento, stesso transformer di prima. L'unica cosa che sparisce è il passaggio "leggo questa sequenza di lettere e capisco di chi stiamo parlando".
E la reversal la impara.
Quindi la relazione non è il problema: quella il modello la sa girare benissimo. Il problema è il ponte tra il nome e la cosa. E più precisamente: quel ponte non regge quando la stessa entità cambia ruolo.
Nelle scienze cognitive questo fenomeno ha un nome da decenni: si chiama binding problem.
È quando incontri uno per strada e sai perfettamente chi è: dove lavora, con chi sta, che avete fatto le medie insieme. Il nome non ti viene. Nessuno direbbe che in quel momento ti manca un modello di quella persona, sai tutto di lui. Ti manca l'etichetta.
Ecco, la differenza sta tutta lì. Un pappagallo sbaglia perché sotto non c'è niente. Qui sotto c'è tutto, e quello che si è rotto è il filo che lo tiene attaccato al nome.
Il pappagallo non è morto: è un caso limite. Descrive un fallimento del sistema. Non descrive il sistema.
Comprimere è comprendere
E allora perché una macchina addestrata a indovinare la parola successiva dovrebbe costruirsi un modello del mondo?
La risposta più elegante che conosco è un argomento che Ilya Sutskever ripete da anni, e si regge tutto su una sola parola: compressione.
Prevedere il token successivo su un corpus grande quanto tutto lo scritto mai prodotto, avendo a disposizione un numero finito di parametri, è un problema di compressione. Devi far stare quel testo in quello spazio. E a quel punto hai due strade.
La memorizzazione pura è la peggior compressione possibile: occupa tantissimo e non ti serve a niente sulla frase dopo. Le regolarità che hanno prodotto quel testo, invece, sono compatte e riutilizzabili.
Detto in un altro modo: il testo del mondo è stato scritto da persone che vivevano dentro una realtà con delle leggi. Per prevedere bene quel testo, il modo più economico è ricostruire quelle leggi. La statistica è il mezzo. La semantica è la scorciatoia che la rete trova da sola perché costa meno.
Bello come argomento. Il punto è che non è più solo un argomento.
La prova che preferisco
Nel 2023 un gruppo di ricercatori di Harvard e Northeastern ha addestrato un piccolo GPT su Othello per provare a prevedere la mossa successiva in liste di partite. Il modello non ha mai visto una scacchiera (di base neanche sa esista) e non sa cosa sia Othello. Vede sequenze di sigle, che noi appunto interpretiamo come mosse.
Poi sono andati a frugargli dentro con delle sonde, e nelle attivazioni c'era tutto, compresa la scacchiera. Lo stato della partita, casella per casella, ricostruito da solo senza alcun input.
E qui arriva la parte che chiude la questione. Una correlazione si può sempre liquidare come coincidenza, quindi hanno fatto l'unica cosa che il dubbio lo toglie davvero: sono intervenuti. Hanno modificato chirurgicamente quella rappresentazione interna modificando il contenuto di una cella, e gli hanno chiesto la mossa successiva.
Il modello ha risposto in modo coerente con la scacchiera falsa.
C'è pure una postilla che a me diverte parecchio: all'inizio la scacchiera sembrava codificata in modo strano e contorto. Poi si è capito che il modello non la rappresentava come "pedine nere e pedine bianche", ma come "le mie e le sue". Il modello del mondo c'era; semplicemente non era nelle nostre coordinate.
Teniamocela da parte, questa, che serve dopo.
E non è un caso isolato
- Sonde su modelli della famiglia Llama hanno tirato fuori rappresentazioni lineari di spazio e tempo: nomi di città disposti in una struttura interna da cui si rileggono latitudine e longitudine, eventi storici allineati lungo un asse temporale. Solo da testo. Nessuna mappa o nessun calendario.
- Il lavoro di interpretabilità di Anthropic sui circuiti interni ha mostrato che quando il modello scrive una poesia in rima sceglie la parola finale prima di scrivere il verso. Se intervieni su quella parola, il verso si riorganizza per atterrare altrove. Cioè: pianifica. Il che è letteralmente il contrario di "sceglie una parola alla volta senza sapere dove sta andando".
- Lo stesso lavoro mostra che concetti identici espressi in lingue diverse convergono negli stessi circuiti interni. Sotto l'italiano e sotto il cinese c'è lo stesso posto.
Il polpo di Bender e Koller non ha mai visto un orso. Ma se ha letto abbastanza di orsi, di boschi, di paura e di leve, allora saprà cosa rispondere.
"Sì ma sono solo algoritmi"
Questa è l'obiezione finale, quella che salta fuori quando tutto il resto è stato concesso: in fondo è solo matematica, sono solo moltiplicazioni tra matrici, è solo codice.
Ed è vero. È letteralmente vero. Il problema è che come argomento non funziona, perché è riduzionismo.
Con lo stesso identico ragionamento, Notte stellata è un po' di pigmento chimico spalmato su un pezzo di tela. La descrizione è corretta al 100%, e non spiega niente di quello che succede quando lo guardi.
Salvatore Sanfilippo, creatore di Redis e Ds4 (per quanto mi riguarda uno dei pochi davvero coscienti nell'ambito), spiega questo concetto in maniera elegantissima in un suo video che potete trovare qui. Lo fa tramite un parallelismo con l'acqua e i vortici, io ci provo con gli storni.
Gli storni
Al tramonto ci sono nuvole di storni che si piegano e si torcono come se fossero un unico animale. Chiunque le abbia mai viste ha avuto per un attimo l'impressione che qualcuno, lassù, stesse dirigendo il traffico.
Non c'è nessuno che dirige. E la cosa notevole è che lo sappiamo per certo, perché è stato misurato: il gruppo che ha studiato quelle nuvole (quelle sopra Roma Termini) è quello di Giorgio Parisi, Nobel per la fisica nel 2021 proprio per il lavoro sui sistemi disordinati.
Da quelle misure sono venute fuori due cose fichissime:
- Non esiste un "CapoUccello" che dirige ognuno guarda i suoi sei o sette vicini immediati, e basta, indipendentemente da quanto siano lontani. È una regola stupidissima ed è tutto quello che c'è.
- Nonostante questo, le correlazioni dentro lo stormo non hanno una scala caratteristica: una virata che parte da un bordo attraversa tutto il gruppo senza attenuarsi, per quanto grande sia il gruppo. Lo stormo si comporta come un corpo unico pur essendo fatto solo di regolette locali.
Ecco: nessuna delle proprietà che vedi guardando in su esiste dentro un singolo storno. Non è che ogni uccello ne abbia un pezzetto. Non ci sono proprio. Emergono dall'interazione, e il livello a cui le descrivi non è il livello a cui sono scritte le regole.
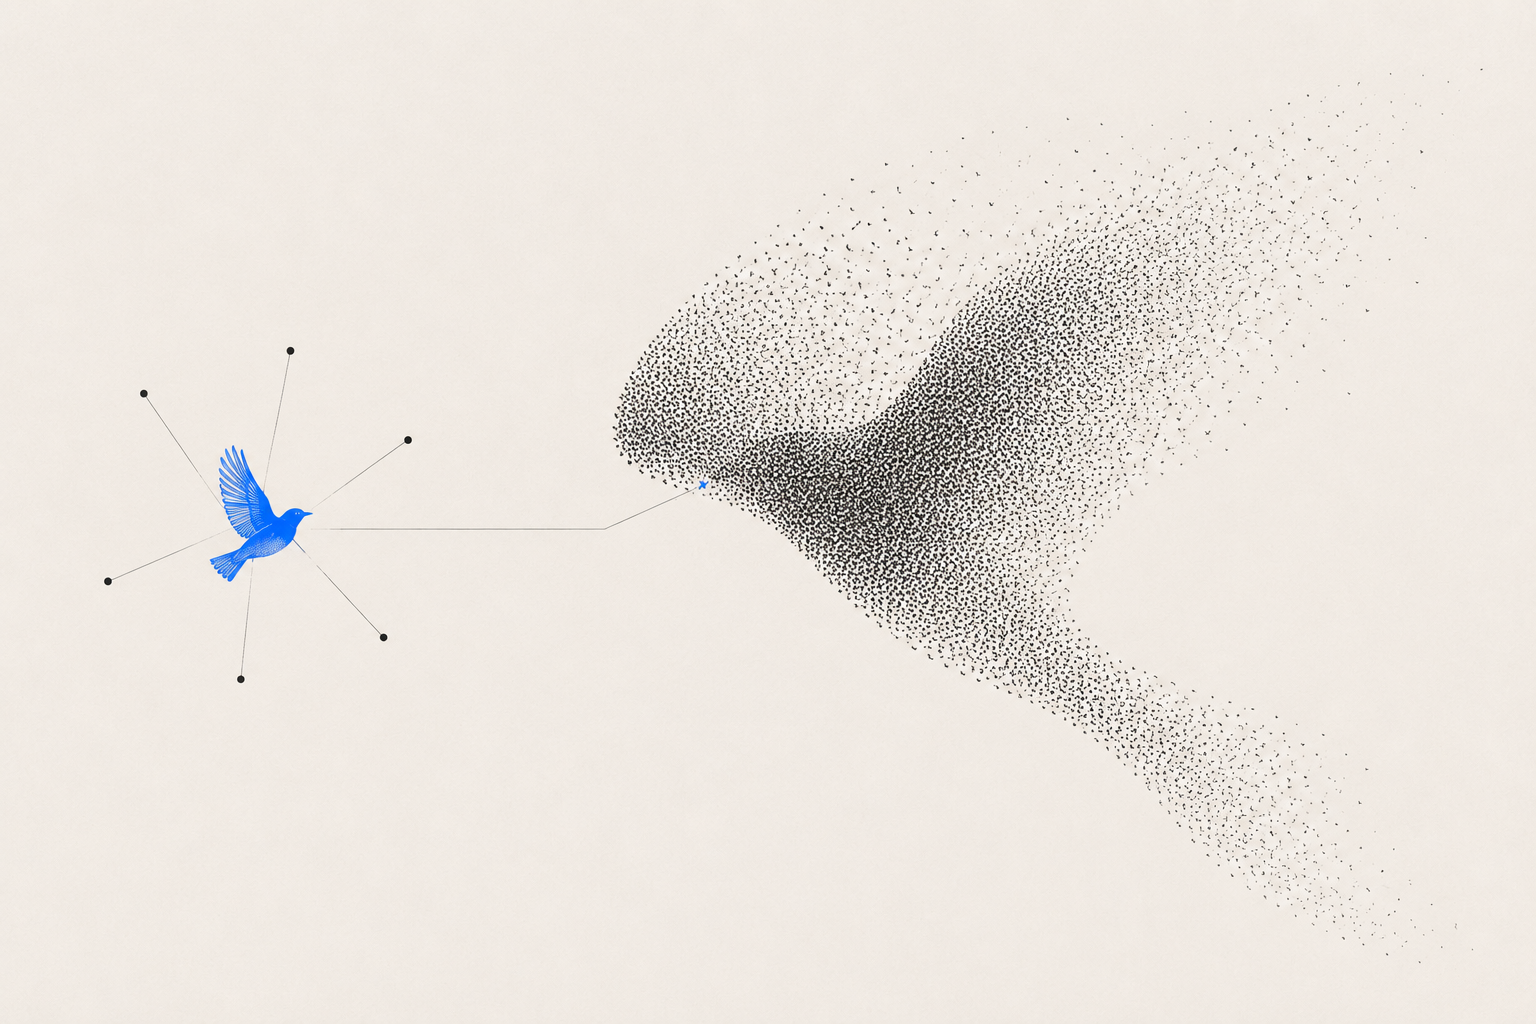
Qualche centinaio di miliardi di parametri che interagiscono a ogni singolo token è, sotto ogni aspetto rilevante, un sistema complesso. Dire "sono solo algoritmi" per chiudere il discorso equivale a dire che uno stormo è solo un mucchio di uccelli. Vero, e completamente inutile.
Il paper non va buttato, va promosso
E adesso che abbiamo guardato cosa c'è dentro questi sistemi, possiamo tornare al 2021 come promesso.
Dicevo all'inizio che il pappagallo, in quel paper, è un paragrafo. Il resto sono quattro avvertimenti, ed è la parte che non cita mai nessuno:
- Costi. Addestrare modelli sempre più grandi costa energia e soldi in quantità difficili da giustificare, e il conto ambientale lo paga soprattutto chi di quei modelli non vedrà mai un beneficio.
- Dati che nessuno ha letto. Un dataset da centinaia di miliardi di parole non lo documenta più nessuno. E internet non è l'umanità: è la porzione di umanità che ha connessione, tempo libero e voglia di scrivere. Il modello eredita quel punto di vista e lo restituisce con l'autorevolezza di una macchina.
- Costo-opportunità. Se scalare funziona, tutta la ricerca si accalca lì e le strade alternative smettono di essere percorse.
- Manipolazione. Testo plausibile a costo zero, in quantità industriale, è un problema anche se la macchina non capisce niente. Anzi: soprattutto se non capisce niente.
Cinque anni dopo, nessuno di questi quattro punti è stato smentito, anzi sembra quasi avessero la sfera di cristallo.
E il secondo, adesso, pesa molto più di quanto pesasse allora. Perché se questi sistemi un modello del mondo ce l'hanno davvero, i bias di cui parlava Bender smettono di essere macchie sull'output e diventano struttura. Il che rende ogni singola preoccupazione di quel paper più urgente.
Perché è diventata una bandiera
Va detta anche questa, perché spiega parecchio di come è andata dopo. Quel paper, quando era ancora una bozza in revisione interna, è costato a Timnit Gebru il posto in Google: siamo a dicembre 2020, tre mesi prima che uscisse. L'azienda sostiene che si sia dimessa, lei sostiene di essere stata licenziata. Margaret Mitchell, che co-dirigeva lo stesso team di Ethical AI e che avrebbe poi firmato con lo pseudonimo di cui sopra, è uscita due mesi dopo.
Da quel momento il pappagallo stocastico ha smesso di essere un'ipotesi scientifica ed è diventato una bandiera.
E il problema delle bandiere è che nessuno le aggiorna.
Ecco perché quello che va abbandonato non è il paper: è l'uso che ne è stato fatto. Un'ipotesi del 2021 usata come scudo nel 2026 non è rigore scientifico. È l'esatto opposto, politica.
Ci manca la parola
Il vero problema, alla fine, è che abbiamo due caselle: capisce e non capisce. E sono sbagliate tutte e due.
"Non capisce" non regge più davanti a un sistema che pianifica una rima tre parole prima di scriverla e che tiene i concetti in un posto solo a prescindere dalla lingua.
Ma non regge nemmeno "capisce", almeno non nel senso in cui lo diciamo di un essere umano: per noi capire significa vivere, interagire con il mondo, e lì dentro di esperienza vissuta non ce n'è.
Quello che c'è è una terza cosa, per cui non abbiamo il termine: una semantica senza referente. Che ha un modello del mondo, costruito interamente a partire dall'ombra che il mondo ha proiettato sul testo.
E qui torna la nota di prima, quella della scacchiera "le mie e le sue". Perché la lezione non è che il modello ci somiglia. È il contrario: il modello del mondo c'è, ma è scritto in coordinate sue. Non sono le nostre e non c'era motivo che lo fossero.
Fonti
- Bender, Gebru, McMillan-Major, Shmitchell — On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? 🦜 (FAccT 2021)
- Bender & Koller — Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data (ACL 2020), l'esperimento del polpo
- Li, Hopkins, Bau, Viégas, Pfister, Wattenberg — Emergent World Representations: Exploring a Sequence Model Trained on a Synthetic Task (ICLR 2023)
- Gurnee & Tegmark — Language Models Represent Space and Time (2023)
- Anthropic — On the Biology of a Large Language Model (2025)
- Berglund et al. — The Reversal Curse (2023)
- Wang & Sun — Is the Reversal Curse a Binding Problem? Uncovering Limitations of Transformers from a Basic Generalization Failure (2025), l'esperimento sui concetti astratti
- Mirzadeh et al. — GSM-Symbolic (ICLR 2025)
- Długosz, Oliveira, Díaz-Rodríguez — The Importance of Being Statistically Earnest: A Critical Re-evaluation of GSM-Symbolic (2026)
- Benjamin Sturgeon — Revisiting GSM-Symbolic: Do 2026 Frontier Models Still Fail at Confounded Grade School Math? (2026), la replica sui distrattori
- Ballerini et al. (PNAS 2008) e Cavagna et al. (PNAS 2010), progetto STARFLAG, sugli stormi di storni sopra Roma
- Salvatore Sanfilippo — Se anche voi siete stanchi di chi vi dice che gli LLM sono pappagalli stocastici e algoritmi, che è lo spunto da cui è partito questo articolo